모든 문장을 "웅—"으로 읽던 AI를 고친 날
한 줄 요약: 두 시간 넘게 학습한 한국어 모델이 어떤 문장을 넣어도 “웅—” 소리만 냈습니다. 원인은 모델에 들어가는 정보 하나가 너무 “시끄러웠던” 것이었고, 그 소리를 줄여 주자 드디어 말을 하기 시작했습니다.
학습은 끝났는데
지난 글에서 말한 대로, 넥슨의 한국어 버전으로 기본 모델을 처음부터 학습시켰습니다. 2시간 반 동안 에러 없이 잘 돌았습니다.
그런데 결과를 들어 보니 모든 문장이 똑같은 “웅—” 소리였습니다. 음절도 없고, 쉬는 부분도 없고, 같은 높이의 소리만 쭉 이어졌습니다. 케이도, 다른 학생도, 어느 중간 저장본도 다 같았습니다.
직접 들어 보면 이렇습니다. 문장은 “안녕하세요, 선생님. 오늘도 잘 부탁드립니다.”입니다.
고장 났을 때: 무슨 문장을 넣어도 웅— (16kHz로 압축된 파일이라 음질이 낮습니다)
어디가 고장 났나: 하나씩 떼어 보기
TTS는 크게 두 부분으로 되어 있습니다.
- 글을 읽는 부분: 문장을 보고 “어떤 소리를 얼마나 길게 낼지” 계획합니다.
- 소리를 만드는 부분: 그 계획대로 실제 소리를 만듭니다.
그래서 하나씩 시험해 봤습니다.
- 진짜 녹음을 넣고 소리 만드는 부분만 거쳐 보니 → 원래 목소리가 멀쩡하게 나옴
- 글자만 넣어 보니 → “웅—”
소리를 만드는 쪽은 멀쩡하고, 글을 읽는 쪽이 고장 난 것이었습니다. 더 들여다보니 글을 읽는 부분은 어떤 문장을 넣든 똑같은 답을 내놓고 있었습니다. 무슨 질문을 해도 같은 대답만 하는 학생처럼, 아예 문장을 안 보고 있었던 겁니다.
범인: 너무 시끄러운 힌트
글을 읽는 부분에는 두 가지 정보가 들어갑니다.
- 발음 기호: “ㄱ, ㅏ, ㄴ…” 같은 실제 발음
- 문장 뜻 힌트: 다른 AI(BERT)가 문장을 읽고 “여기는 질문이야, 여기는 강조야” 같은 분위기를 숫자로 알려 주는 것
그런데 이 뜻 힌트 숫자 중 몇 개가 문장과 상관없이 항상 엄청 큰 값이었습니다. 회의에서 한 사람이 내용과 상관없이 계속 같은 말을 소리치는 상황이라고 보면 됩니다. 모델이 그 큰 소리에 묻혀서, 정작 중요한 발음 기호를 무시하는 쪽으로 굳어 버렸습니다.
해결: 볼륨을 맞추고 줄이기
방법은 간단했습니다. 뜻 힌트 숫자들을 모두 비슷한 크기로 맞추고, 전체 볼륨을 10분의 1로 줄였습니다. 이제 뜻 힌트는 옆에서 조용히 거드는 역할만 하고, 모델은 발음 기호를 제대로 봅니다.
큰 학습 전에 작은 시험부터
전체 20시간으로 다시 돌리면 또 몇 시간이 걸립니다. 그래서 먼저 한 사람 목소리 130문장만으로 30분짜리 시험을 했습니다.
| 시험 | 결과 |
|---|---|
| 뜻 힌트 그대로 | 계속 “웅—” 쪽으로 감 |
| 뜻 힌트 빼기 | 6천 번쯤 반복했을 때 말소리가 생김 |
| 뜻 힌트 볼륨 맞추고 줄이기 | 같은 시점에 말소리가 생기고, 더 빨리 좋아짐 |
작은 시험에서 확신을 얻고, 그 상태에서 출발해 전체 데이터로 다시 학습했습니다. 이번에는 처음부터 음절이 나뉘고, 쉼표에서 쉬고, 억양이 오르내렸습니다. 드디어 문장을 읽기 시작했습니다.
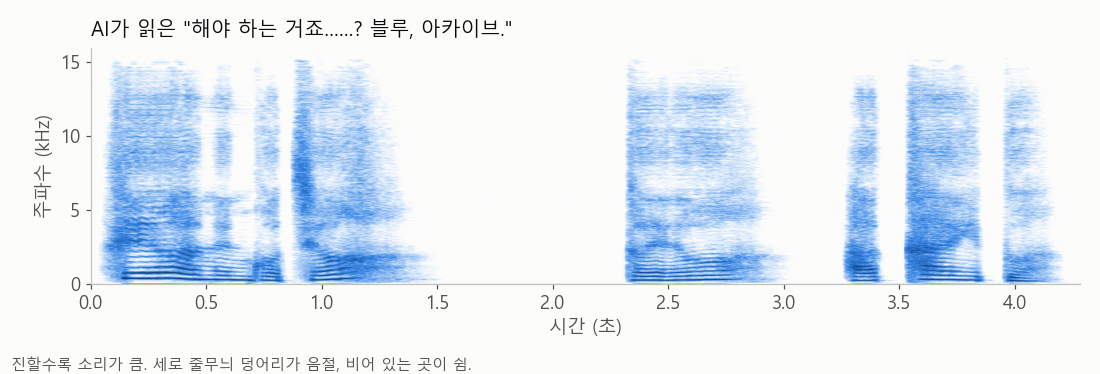
고친 뒤: 같은 문장 "안녕하세요, 선생님. 오늘도 잘 부탁드립니다." (다음 날 더 학습한 최종 모델)
소리를 그림으로 그린 것(스펙트로그램)입니다. “웅—”일 때는 한 덩어리로 쭉 이어졌는데, 이제 음절마다 끊기고 “……?” 자리에서 길게 쉽니다.
오늘 배운 것
- “학습이 끝났다”와 “제대로 배웠다”는 다릅니다. 결과를 꼭 들어 봐야 합니다.
- 고장 나면 부분을 하나씩 떼어서 시험하면 범인을 빨리 찾을 수 있습니다.
- 큰 실험 전에 작은 실험을 먼저 하면 시간이 훨씬 절약됩니다.
다음 글: 말은 하는데 아직 로봇 같다